主键表
主键表使用了由 StarRocks 设计的新型存储引擎。其主要优势在于支持实时数据更新,同时确保复杂即席查询的高效性能。在实时业务分析中,决策可以受益于主键表,它使用最新数据实时分析结果,从而减少数据分析中的数据延迟。 然而,主键并非免费的午餐。如果使用不当,可能会导致不必要的资源浪费。
因此,在本节中,我们将指导您如何更高效地使用主键模型以达到预期效果。
选择主键索引
主键索引是主键表中最关键的组成部分。主键索引用于存储主键值与由主键值标识的数据行所在位置之间的映射关系。
目前,我们支持三种类型的主键索引:
- 全内存主键索引。
PROPERTIES (
    "enable_persistent_index" = "false"
);
- 基于本地磁盘的持久化主键索引。
PROPERTIES (
    "enable_persistent_index" = "true",
    "persistent_index_type" = "LOCAL"
);
- 云原生持久化主键索引。
PROPERTIES (
    "enable_persistent_index" = "true",
    "persistent_index_type" = "CLOUD_NATIVE"
);
我们NOT建议使用全内存索引,因为它会导致大量内存资源浪费。
如果您使用的是存算分离(弹性)StarRocks 集群,我们建议选择 cloud 原生持久化主键索引。与基于本地磁盘的持久化主键索引不同,它将完整的索引数据存储在远端对象存储中,本地磁盘仅用作缓存。与基于本地磁盘的持久化主键索引相比,其优势包括:
- 不依赖本地磁盘容量。
- 数据分片重新均衡后无需重建索引。
选择主键
主键通常无助于加速查询。您可以使用 ORDER BY 子句指定与主键不同的列作为排序键以加快查询速度。因此,在选择主键时,您只需考虑数据导入和更新过程中的唯一性。
主键越大,占用的内存、I/O 和其他资源就越多。因此,通常建议避免选择过多或过大的列作为主键。主键的默认最大大小为 128 字节,由 be.conf 中的 primary_key_limit_size 参数控制。
您可以增大 primary_key_limit_size 以选择更大的主键,但请注意,这会导致更高的资源消耗。
持久化索引会占用多少存储和内存空间?
存储空间成本公式
(key size + 8 bytes) * row count * 50%
50% 是估算的压缩效率,实际压缩效果取决于数据本身。
内存成本公式
min(l0_max_mem_usage * tablet cnt, update_memory_limit_percent * BE process memory);
内存使用
主键表使用的内存可以通过 mem_tracker 进行监控:
//View the overall memory statistics
http://be_ip:be_http_port/mem_tracker

// View primary key table memory statistics
http://be_ip:be_http_port/mem_tracker?type=update

// View primary key table memory statistics with more details
http://be_ip:be_http_port/mem_tracker?type=update&upper_level=4
mem_tracker 中的 update 项记录了主键表使用的全部内存,例如主键索引、Delete Vector 等。
您也可以通过指标监控服务监控此 update 项。例如,在 Grafana 中,您可以通过以下方式查看 update 项(红框中的项):
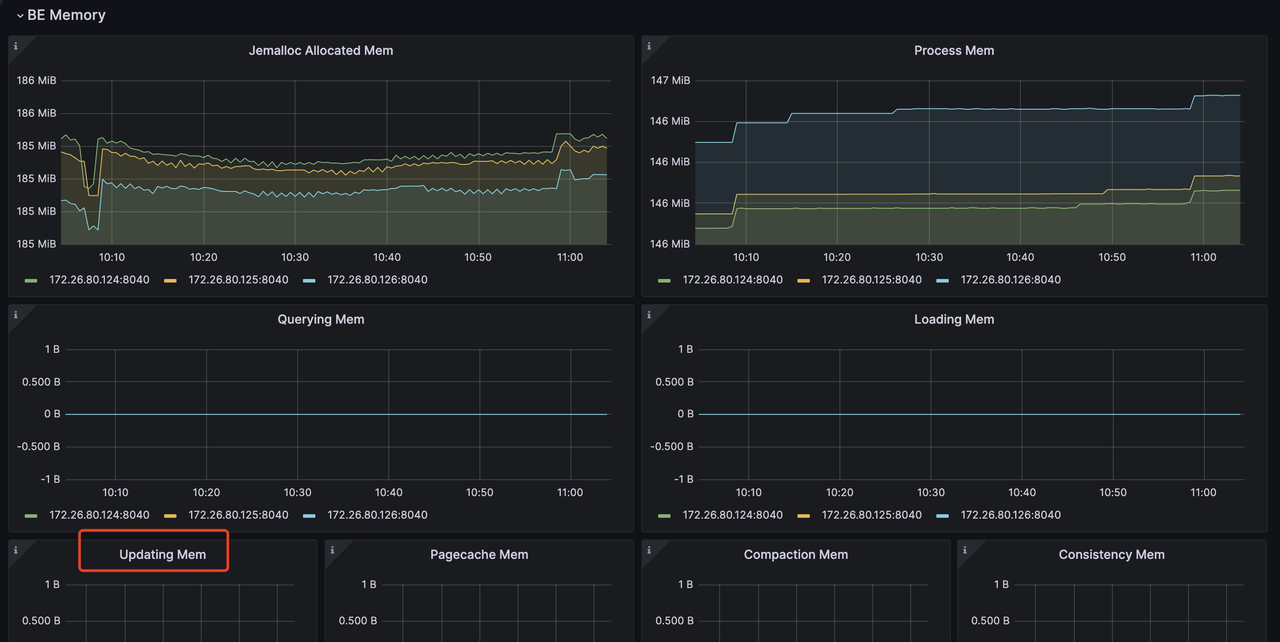
如果您对内存使用较为敏感,希望在主键表导入过程中减少内存消耗,可以通过以下配置来实现:
be.conf

l0_max_mem_usage = (some value which smaller than 104857600, default is 104857600)

// Shared-nothing cluster
transaction_apply_worker_count = (some value smaller than cpu core number, default is cpu core number)

// Shared-data cluster
transaction_publish_version_worker_count = (some value smaller than cpu core number, default is cpu core number)
l0_max_mem_usage 控制每个 tablet 的持久化主键索引的最大内存使用量。transaction_apply_worker_count 和 transaction_publish_version_worker_count 均控制可用于处理主键表中 upsert 和 delete 操作的最大线程数。
但需要注意,降低 l0_max_mem_usage 可能会增加 I/O 压力,而降低 transaction_apply_worker_count 或 transaction_publish_version_worker_count 可能会减慢数据导入速度。
在 Compaction 资源、数据新鲜度和查询延迟之间进行权衡
与其他表模型相比,主键表在数据导入、更新和删除过程中需要额外的主键索引查找和 Delete Vector 生成操作,这会引入额外的资源开销。 因此,您需要在以下三个因素之间进行权衡:
- Compaction 资源限制。
- 数据新鲜度
- 查询延迟
数据新鲜度和查询延迟
如果您希望获得更好的数据新鲜度,同时也希望获得更低的查询延迟,这意味着您将引入高频写入,并且希望确保它们能够尽快完成 Compaction。 这样您就需要更多的 Compaction 资源来处理这些写入:
// shared-data
be.conf
compact_threads = 4

// shared-nothing
be.conf
update_compaction_num_threads_per_disk = 1
update_compaction_per_tablet_min_interval_seconds = 120
您可以增大 compact_threads 和 update_compaction_num_threads_per_disk,或减小 update_compaction_per_tablet_min_interval_seconds,以引入更多 Compaction 资源来处理高频写入。
您如何知道当前的 Compaction 资源和设置是否能够应对当前的高频写入?您可以通过以下方式观察:
-
对于存算分离集群,如果 Compaction 跟不上导入速率,可能会导致导入速度变慢,甚至出现写入失败错误并停止导入。 a. 导入速度变慢。 您可以使用
show proc /transactions/{db_name}/running';查看当前正在运行的事务,如果出现类似以下的减速信息:Partition's compaction score is larger than 100.0, delay commit for xxxms. You can try to increase compaction concurrency
出现在 ErrMsg 字段中,这表示发生了导入速度变慢的情况。 例如:
show proc '/transactions/test_pri_load_c/running';
+---------------+----------------------------------------------+------------------+-------------------+--------------------+---------------------+------------+-------------+------------+----------------------------------------------------------------------------------------------------------------------------+--------------------+------------+-----------+--------+
| TransactionId | Label                                        | Coordinator      | TransactionStatus | LoadJobSourceType  | PrepareTime         | CommitTime | PublishTime | FinishTime | Reason                                                                                                                     | ErrorReplicasCount | ListenerId | TimeoutMs | ErrMsg |
+---------------+----------------------------------------------+------------------+-------------------+--------------------+---------------------+------------+-------------+------------+----------------------------------------------------------------------------------------------------------------------------+--------------------+------------+-----------+--------+
| 1034          | stream_load_d2753fbaa0b343acadd5f13de92d44c1 | FE: 172.26.94.39 | PREPARE           | FRONTEND_STREAMING | 2024-10-24 13:05:01 | NULL       | NULL        | NULL       | Partition's compaction score is larger than 100.0, delay commit for 6513ms. You can try to increase compaction concurrency, | 0                  | 11054      | 86400000  |        |
+---------------+----------------------------------------------+------------------+-------------------+--------------------+---------------------+------------+-------------+------------+----------------------------------------------------------------------------------------------------------------------------+--------------------+------------+-----------+--------+
b. 导入停止。 如果出现类似以下的导入错误:
Failed to load data into partition xxx, because of too large compaction score, current/limit: xxx/xxx. You can reduce the loading job concurrency, or increase compaction concurrency
这意味着由于 Compaction 无法跟上当前的高频写入,导致导入停止。
- 对于存算一体集群,如果 Compaction 无法跟上当前的高频写入,没有导入减速策略。导入将失败并返回错误消息:
Failed to load data into tablet xxx, because of too many versions, current/limit: xxx/xxx. You can reduce the loading job concurrency, or increase loading data batch size. If you are loading data with Routine Load, you can increase FE configs routine_load_task_consume_second and max_routine_load_batch_size.
数据新鲜度与 Compaction 资源限制
如果您的 Compaction 资源有限,但仍需要保持足够的数据新鲜度,这意味着您需要牺牲一些查询延迟。
您可以进行以下配置更改来实现这一点:
- 存算分离集群
fe.conf

lake_ingest_slowdown_threshold = xxx (default is 100, you can increase it)
lake_compaction_score_upper_bound = xxx (default is 2000, you can increase it)
lake_ingest_slowdown_threshold 参数控制触发导入减速的阈值。当某个分区的 Compaction 分数超过该阈值时,系统将开始降低数据导入速度。类似地,lake_compaction_score_upper_bound 决定触发导入停止的阈值。
- 存算一体集群
be.conf

tablet_max_versions = xxx (default is 1000, you can increase it)
tablet_max_versions 决定触发导入停止的阈值。
通过增大这些配置,系统可以容纳更多的小数据文件并降低 Compaction 频率,但这也会影响查询延迟。
查询延迟与 Compaction 资源限制
如果您希望在 Compaction 资源有限的情况下实现良好的查询延迟,需要降低写入频率,并为导入创建更大的数据批次。
有关具体实现方式,请参阅不同导入方式的相关章节,这些章节详细说明了如何降低导入频率并增大批次大小。