HDFS からのデータロード
StarRocks は、HDFS からデータをロードするために次のオプションを提供します。
- Synchronous loading using INSERT+
FILES() - Asynchronous loading using Broker Load
- Continuous asynchronous loading using Pipe
Each of these options has its own advantages, which are detailed in the following sections.
In most cases, we recommend that you use the INSERT+FILES() method, which is much easier to use.
However, the INSERT+FILES() method currently supports only the Parquet and ORC file formats. Therefore, if you need to load data of other file formats such as CSV, or perform data changes such as DELETE during data loading, you can resort to Broker Load.
If you need to load a large number of data files with a significant data volume in total (for example, more than 100 GB or even 1 TB), we recommend that you use the Pipe method. Pipe can split the files based on their number or size, breaking down the load job into smaller, sequential tasks. This approach ensures that errors in one file do not impact the entire load job and minimizes the need for retries due to data errors.
始める前に
ソースデータの準備
StarRocks にロードしたいソースデータが HDFS クラスターに適切に保存されていることを確認してください。このトピックでは、HDFS から StarRocks に /user/amber/user_behavior_ten_million_rows.parquet をロードすることを前提としています。
権限の確認
You can load data into StarRocks tables only as a user who has the INSERT privilege on those StarRocks tables. If you do not have the INSERT privilege, follow the instructions provided in GRANT to grant the INSERT privilege to the user that you use to connect to your StarRocks cluster. The syntax is GRANT INSERT ON TABLE <table_name> IN DATABASE <database_name> TO { ROLE <role_name> | USER <user_identity>}.
認証情報の収集
HDFS クラスターとの接続を確立するために、シンプルな認証方法を使用できます。シンプルな認証を使用するには、HDFS クラスターの NameNode にアクセスするためのアカウントのユーザー名とパスワードを収集する必要があります。
INSERT+FILES() の使用
この方法は v3.1 以降で利用可能で、現在は Parquet と ORC ファイル形式のみをサポートしています。
INSERT+FILES() の利点
FILES() は、指定したパス関連のプロパティに基づいてクラウドストレージに保存されたファイルを読み取り、ファイル内のデータのテーブルスキーマを推測し、データ行としてファイルからデータを返すことができます。
FILES() を使用すると、次のことが可能です:
- SELECT を使用して HDFS から直接データをクエリします。
- CREATE TABLE AS SELECT (CTAS) を使用してテーブルを作成し、ロードします。
- INSERT を使用して既存のテーブルにデータをロードします。
典型的な例
SELECT を使用して HDFS から直接クエリ
SELECT+FILES() を使用して HDFS から直接クエリすることで、テーブルを作成する前にデータセットの内容をプレビューできます。例えば:
- データを保存せずにデータセットをプレビューします。
- 最小値と最大値をクエリし、使用するデータ型を決定します。
NULL値をチェックします。
次の例では、HDFS クラスターに保存されているデータファイル /user/amber/user_behavior_ten_million_rows.parquet をクエリします:
SELECT * FROM FILES
(
    "path" = "hdfs://<hdfs_ip>:<hdfs_port>/user/amber/user_behavior_ten_million_rows.parquet",
    "format" = "parquet",
    "hadoop.security.authentication" = "simple",
    "username" = "<hdfs_username>",
    "password" = "<hdfs_password>"
)
LIMIT 3;
システムは次のクエリ結果を返します:
+--------+---------+------------+--------------+---------------------+
| UserID | ItemID  | CategoryID | BehaviorType | Timestamp           |
+--------+---------+------------+--------------+---------------------+
| 543711 |  829192 |    2355072 | pv           | 2017-11-27 08:22:37 |
| 543711 | 2056618 |    3645362 | pv           | 2017-11-27 10:16:46 |
| 543711 | 1165492 |    3645362 | pv           | 2017-11-27 10:17:00 |
+--------+---------+------------+--------------+---------------------+
NOTE
上記で返された列名は、Parquet ファイルによって提供されています。
CTAS を使用してテーブルを作成しロード
これは前の例の続きです。前のクエリは CREATE TABLE AS SELECT (CTAS) でラップされ、スキーマ推測を使用してテーブル作成を自動化します。これは、StarRocks がテーブルスキーマを推測し、希望するテーブルを作成し、データをテーブルにロードすることを意味します。Parquet ファイルを使用する場合、Parquet 形式には列名が含まれているため、FILES() テーブル関数を使用する際にテーブルを作成するための列名と型は必要ありません。
NOTE
スキーマ推測を使用する場合の CREATE TABLE の構文では、レプリカの数を設定することはできませんので、テーブルを作成する前に設定してください。以下の例は、3 つのレプリカを持つシステムの例です:
ADMIN SET FRONTEND CONFIG ('default_replication_num' = "3");
データベースを作成し、切り替えます:
CREATE DATABASE IF NOT EXISTS mydatabase;
USE mydatabase;
CTAS を使用してテーブルを作成し、データファイル /user/amber/user_behavior_ten_million_rows.parquet のデータをテーブルにロードします:
CREATE TABLE user_behavior_inferred AS
SELECT * FROM FILES
(
    "path" = "hdfs://<hdfs_ip>:<hdfs_port>/user/amber/user_behavior_ten_million_rows.parquet",
    "format" = "parquet",
    "hadoop.security.authentication" = "simple",
    "username" = "<hdfs_username>",
    "password" = "<hdfs_password>"
);
テーブルを作成した後、そのスキーマを DESCRIBE を使用して表示できます:
DESCRIBE user_behavior_inferred;
システムは次のクエリ結果を返します:
+--------------+-----------+------+-------+---------+-------+
| Field        | Type      | Null | Key   | Default | Extra |
+--------------+-----------+------+-------+---------+-------+
| UserID       | bigint    | YES  | true  | NULL    |       |
| ItemID       | bigint    | YES  | true  | NULL    |       |
| CategoryID   | bigint    | YES  | true  | NULL    |       |
| BehaviorType | varbinary | YES  | false | NULL    |       |
| Timestamp    | varbinary | YES  | false | NULL    |       |
+--------------+-----------+------+-------+---------+-------+
テーブルをクエリして、データがロードされたことを確認します。例:
SELECT * from user_behavior_inferred LIMIT 3;
次のクエリ結果が返され、データが正常にロードされたことを示しています:
+--------+--------+------------+--------------+---------------------+
| UserID | ItemID | CategoryID | BehaviorType | Timestamp           |
+--------+--------+------------+--------------+---------------------+
|     84 |  56257 |    1879194 | pv           | 2017-11-26 05:56:23 |
|     84 | 108021 |    2982027 | pv           | 2017-12-02 05:43:00 |
|     84 | 390657 |    1879194 | pv           | 2017-11-28 11:20:30 |
+--------+--------+------------+--------------+---------------------+
INSERT を使用して既存のテーブルにロード
挿入するテーブルをカスタマイズしたい場合があります。例えば:
- 列のデータ型、NULL 設定、またはデフォルト値
- キーの種類と列
- データのパーティショニングとバケッティング
NOTE
最も効率的なテーブル構造を作成するには、データの使用方法と列の内容に関する知識が必要です。このトピックではテーブル設計については扱いません。テーブル設計に関する情報は、Table types を参照してください。
この例では、テーブルがどのようにクエリされるか、Parquet ファイル内のデータに関する知識に基づいてテーブルを作成しています。Parquet ファイル内のデータに関する知識は、HDFS でファイルを直接クエリすることで得られます。
- HDFS のデータセットのクエリにより、
Timestamp列が VARBINARY データ型に一致するデータを含むことが示されているため、次の DDL で列型が指定されています。 - HDFS のデータをクエリすることで、データセットに
NULL値がないことがわかるため、DDL では任意の列を NULL 許可として設定していません。 - 予想されるクエリタイプに基づいて、ソートキーとバケッティング列は
UserID列に設定されています。このデータに対するユースケースは異なるかもしれないので、ソートキーとしてItemIDを使用することを決定するかもしれません。
データベースを作成し、切り替えます:
CREATE DATABASE IF NOT EXISTS mydatabase;
USE mydatabase;
手動でテーブルを作成します(HDFS からロードしたい Parquet ファイルと同じスキーマを持つことをお勧めします):
CREATE TABLE user_behavior_declared
(
    UserID int(11),
    ItemID int(11),
    CategoryID int(11),
    BehaviorType varchar(65533),
    Timestamp varbinary
)
ENGINE = OLAP
DUPLICATE KEY(UserID)
DISTRIBUTED BY HASH(UserID);
スキーマを表示して、FILES() テーブル関数によって生成された推測スキーマと比較できるようにします:
DESCRIBE user_behavior_declared;
+--------------+----------------+------+-------+---------+-------+
| Field        | Type           | Null | Key   | Default | Extra |
+--------------+----------------+------+-------+---------+-------+
| UserID       | int            | NO   | true  | NULL    |       |
| ItemID       | int            | NO   | false | NULL    |       |
| CategoryID   | int            | NO   | false | NULL    |       |
| BehaviorType | varchar(65533) | NO   | false | NULL    |       |
| Timestamp    | varbinary      | NO   | false | NULL    |       |
+--------------+----------------+------+-------+---------+-------+
5 rows in set (0.00 sec)
先ほど作成したスキーマを、FILES() テーブル関数を使用して以前に推測されたスキーマと比較します。以下を確認してください:
- データ型
- NULL 許可
- キーフィールド
ターゲットテーブルのスキーマをより良く制御し、クエリパフォーマンスを向上させるために、本番環境では手動でテーブルスキーマを指定することをお勧めします。
テーブルを作成した後、INSERT INTO SELECT FROM FILES() を使用してロードできます:
INSERT INTO user_behavior_declared
SELECT * FROM FILES
(
    "path" = "hdfs://<hdfs_ip>:<hdfs_port>/user/amber/user_behavior_ten_million_rows.parquet",
    "format" = "parquet",
    "hadoop.security.authentication" = "simple",
    "username" = "<hdfs_username>",
    "password" = "<hdfs_password>"
);
ロードが完了した後、テーブルをクエリしてデータがロードされたことを確認できます。例:
SELECT * from user_behavior_declared LIMIT 3;
次のクエリ結果が返され、データが正常にロードされたことを示しています:
+--------+---------+------------+--------------+---------------------+
| UserID | ItemID  | CategoryID | BehaviorType | Timestamp           |
+--------+---------+------------+--------------+---------------------+
|    107 | 1568743 |    4476428 | pv           | 2017-11-25 14:29:53 |
|    107 |  470767 |    1020087 | pv           | 2017-11-25 14:32:31 |
|    107 |  358238 |    1817004 | pv           | 2017-11-25 14:43:23 |
+--------+---------+------------+--------------+---------------------+
ロード進捗の確認
StarRocks Information Schema の loads ビューから INSERT ジョブの進捗をクエリできます。この機能は v3.1 以降でサポートされています。例:
SELECT * FROM information_schema.loads ORDER BY JOB_ID DESC;
loads ビューで提供されるフィールドに関する情報は、loads を参照してください。
複数のロードジョブを送信した場合は、ジョブに関連付けられた LABEL でフィルタリングできます。例:
SELECT * FROM information_schema.loads WHERE LABEL = 'insert_0d86c3f9-851f-11ee-9c3e-00163e044958' \G
*************************** 1. row ***************************
              JOB_ID: 10214
               LABEL: insert_0d86c3f9-851f-11ee-9c3e-00163e044958
       DATABASE_NAME: mydatabase
               STATE: FINISHED
            PROGRESS: ETL:100%; LOAD:100%
                TYPE: INSERT
            PRIORITY: NORMAL
           SCAN_ROWS: 10000000
       FILTERED_ROWS: 0
     UNSELECTED_ROWS: 0
           SINK_ROWS: 10000000
            ETL_INFO:
           TASK_INFO: resource:N/A; timeout(s):300; max_filter_ratio:0.0
         CREATE_TIME: 2023-11-17 15:58:14
      ETL_START_TIME: 2023-11-17 15:58:14
     ETL_FINISH_TIME: 2023-11-17 15:58:14
     LOAD_START_TIME: 2023-11-17 15:58:14
    LOAD_FINISH_TIME: 2023-11-17 15:58:18
         JOB_DETAILS: {"All backends":{"0d86c3f9-851f-11ee-9c3e-00163e044958":[10120]},"FileNumber":0,"FileSize":0,"InternalTableLoadBytes":311710786,"InternalTableLoadRows":10000000,"ScanBytes":581574034,"ScanRows":10000000,"TaskNumber":1,"Unfinished backends":{"0d86c3f9-851f-11ee-9c3e-00163e044958":[]}}
           ERROR_MSG: NULL
        TRACKING_URL: NULL
        TRACKING_SQL: NULL
REJECTED_RECORD_PATH: NULL
NOTE
INSERT は同期コマンドです。INSERT ジョブがまだ実行中の場合、その実行ステータスを確認するには別のセッションを開く必要があります。
Broker Load の使用
非同期の Broker Load プロセスは、HDFS への接続を確立し、データを取得し、StarRocks にデータを保存する処理を行います。
この方法は次のファイル形式をサポートしています:
- Parquet
- ORC
- CSV
- JSON (v3.2.3 以降でサポート)
Broker Load の利点
- Broker Load はバックグラウンドで実行され、クライアントはジョブが続行するために接続を維持する必要がありません。
- Broker Load は長時間実行されるジョブに適しており、デフォルトのタイムアウトは 4 時間です。
- Parquet と ORC ファイル形式に加えて、Broker Load は CSV ファイル形式と JSON ファイル形式をサポートしています(JSON ファイル形式は v3.2.3 以降でサポート)。
データフロー
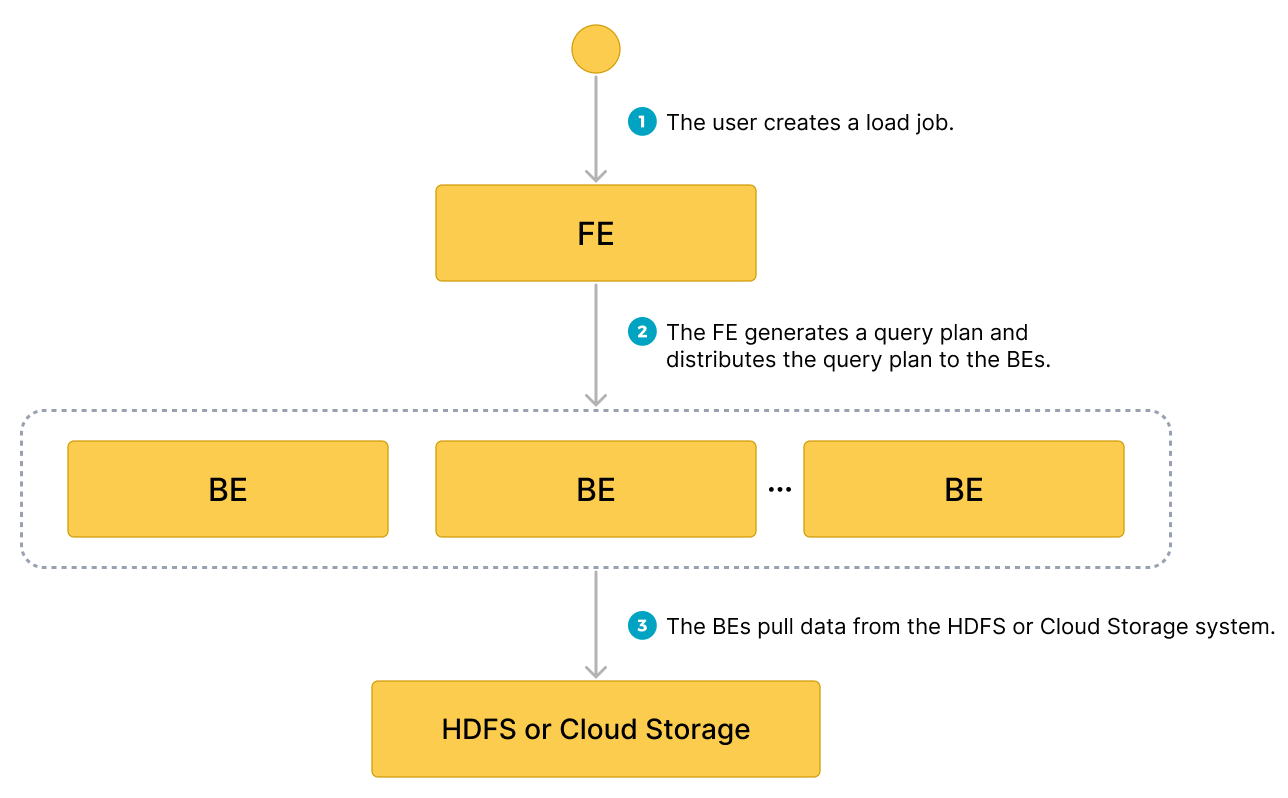
- ユーザーがロードジョブを作成します。
- フロントエンド (FE) がクエリプランを作成し、そのプランをバックエンドノード (BEs) またはコンピュートノード (CNs) に配布します。
- BEs または CNs がソースからデータを取得し、StarRocks にデータをロードします。
典型的な例
テーブルを作成し、HDFS からデータファイル /user/amber/user_behavior_ten_million_rows.parquet を取得するロードプロセスを開始し、データロードの進捗と成功を確認します。
データベースとテーブルの作成
データベースを作成し、切り替えます:
CREATE DATABASE IF NOT EXISTS mydatabase;
USE mydatabase;
手動でテーブルを作成します(HDFS からロードしたい Parquet ファイルと同じスキーマを持つことをお勧めします):
CREATE TABLE user_behavior
(
    UserID int(11),
    ItemID int(11),
    CategoryID int(11),
    BehaviorType varchar(65533),
    Timestamp varbinary
)
ENGINE = OLAP
DUPLICATE KEY(UserID)
DISTRIBUTED BY HASH(UserID);
Broker Load の開始
次のコマンドを実行して、HDFS のデータファイル /user/amber/user_behavior_ten_million_rows.parquet から user_behavior テーブルにデータをロードする Broker Load ジョブを開始します:
LOAD LABEL user_behavior
(
    DATA INFILE("hdfs://<hdfs_ip>:<hdfs_port>/user/amber/user_behavior_ten_million_rows.parquet")
    INTO TABLE user_behavior
    FORMAT AS "parquet"
 )
 WITH BROKER
(
    "hadoop.security.authentication" = "simple",
    "username" = "<hdfs_username>",
    "password" = "<hdfs_password>"
)
PROPERTIES
(
    "timeout" = "72000"
);
このジョブには 4 つの主要なセクションがあります:
LABEL: ロードジョブの状態をクエリする際に使用される文字列。LOAD宣言: ソース URI、ソースデータ形式、および宛先テーブル名。BROKER: ソースの接続詳細。PROPERTIES: タイムアウト値およびロードジョブに適用するその他のプロパティ。
詳細な構文とパラメータの説明については、BROKER LOAD を参照してください。
ロード進捗の確認
information_schema.loads ビューから Broker Load ジョブの進捗をクエリできます。この機能は v3.1 以降でサポートされています。
SELECT * FROM information_schema.loads;
loads ビューで提供されるフィールドに関する情報は、Information Schema を参照してください。
複数のロードジョブを送信した場合は、ジョブに関連付けられた LABEL でフィルタリングできます。例:
SELECT * FROM information_schema.loads WHERE LABEL = 'user_behavior';
以下の出力には、ロードジョブ user_behavior の 2 つのエントリがあります:
- 最初のレコードは
CANCELLED状態を示しています。ERROR_MSGまでスクロールすると、listPath failedによりジョブが失敗したことがわかります。 - 2 番目のレコードは
FINISHED状態を示しており、ジョブが成功したことを意味します。
JOB_ID|LABEL                                      |DATABASE_NAME|STATE    |PROGRESS           |TYPE  |PRIORITY|SCAN_ROWS|FILTERED_ROWS|UNSELECTED_ROWS|SINK_ROWS|ETL_INFO|TASK_INFO                                           |CREATE_TIME        |ETL_START_TIME     |ETL_FINISH_TIME    |LOAD_START_TIME    |LOAD_FINISH_TIME   |JOB_DETAILS                                                                                                                                                                                                                                                    |ERROR_MSG                             |TRACKING_URL|TRACKING_SQL|REJECTED_RECORD_PATH|
------+-------------------------------------------+-------------+---------+-------------------+------+--------+---------+-------------+---------------+---------+--------+----------------------------------------------------+-------------------+-------------------+-------------------+-------------------+-------------------+---------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------+--------------------------------------+------------+------------+--------------------+
 10121|user_behavior                              |mydatabase   |CANCELLED|ETL:N/A; LOAD:N/A  |BROKER|NORMAL  |        0|            0|              0|        0|        |resource:N/A; timeout(s):72000; max_filter_ratio:0.0|2023-08-10 14:59:30|                   |                   |                   |2023-08-10 14:59:34|{"All backends":{},"FileNumber":0,"FileSize":0,"InternalTableLoadBytes":0,"InternalTableLoadRows":0,"ScanBytes":0,"ScanRows":0,"TaskNumber":0,"Unfinished backends":{}}                                                                                        |type:ETL_RUN_FAIL; msg:listPath failed|            |            |                    |
 10106|user_behavior                              |mydatabase   |FINISHED |ETL:100%; LOAD:100%|BROKER|NORMAL  | 86953525|            0|              0| 86953525|        |resource:N/A; timeout(s):72000; max_filter_ratio:0.0|2023-08-10 14:50:15|2023-08-10 14:50:19|2023-08-10 14:50:19|2023-08-10 14:50:19|2023-08-10 14:55:10|{"All backends":{"a5fe5e1d-d7d0-4826-ba99-c7348f9a5f2f":[10004]},"FileNumber":1,"FileSize":1225637388,"InternalTableLoadBytes":2710603082,"InternalTableLoadRows":86953525,"ScanBytes":1225637388,"ScanRows":86953525,"TaskNumber":1,"Unfinished backends":{"a5|                                      |            |            |                    |
ロードジョブが完了したことを確認した後、宛先テーブルのサブセットをチェックして、データが正常にロードされたかどうかを確認できます。例:
SELECT * from user_behavior LIMIT 3;
次のクエリ結果が返され、データが正常にロードされたことを示しています:
+--------+---------+------------+--------------+---------------------+
| UserID | ItemID  | CategoryID | BehaviorType | Timestamp           |
+--------+---------+------------+--------------+---------------------+
|    142 | 2869980 |    2939262 | pv           | 2017-11-25 03:43:22 |
|    142 | 2522236 |    1669167 | pv           | 2017-11-25 15:14:12 |
|    142 | 3031639 |    3607361 | pv           | 2017-11-25 15:19:25 |
+--------+---------+------------+--------------+---------------------+
Pipe の使用
v3.2 から、StarRocks は Pipe ロード方法を提供しており、現在は Parquet と ORC ファイル形式のみをサポートしています。
Pipe の利点
Pipe is ideal for continuous data loading and large-scale data loading:
-
Large-scale data loading in micro-batches helps reduce the cost of retries caused by data errors.
With the help of Pipe, StarRocks enables the efficient loading of a large number of data files with a significant data volume in total. Pipe automatically splits the files based on their number or size, breaking down the load job into smaller, sequential tasks. This approach ensures that errors in one file do not impact the entire load job. The load status of each file is recorded by Pipe, allowing you to easily identify and fix files that contain errors. By minimizing the need for retries due to data errors, this approach helps to reduce costs.
-
Continuous data loading helps reduce manpower.
Pipe helps you write new or updated data files to a specific location and continuously load the new data from these files into StarRocks. After you create a Pipe job with
"AUTO_INGEST" = "TRUE"specified, it will constantly monitor changes to the data files stored in the specified path and automatically load new or updated data from the data files into the destination StarRocks table.
Additionally, Pipe performs file uniqueness checks to help prevent duplicate data loading.During the loading process, Pipe checks the uniqueness of each data file based on the file name and digest. If a file with a specific file name and digest has already been processed by a Pipe job, the Pipe job will skip all subsequent files with the same file name and digest. Note that HDFS uses LastModifiedTime as file digest.
The load status of each data file is recorded and saved to the information_schema.pipe_files view. After a Pipe job associated with the view is deleted, the records about the files loaded in that job will also be deleted.
Data flow
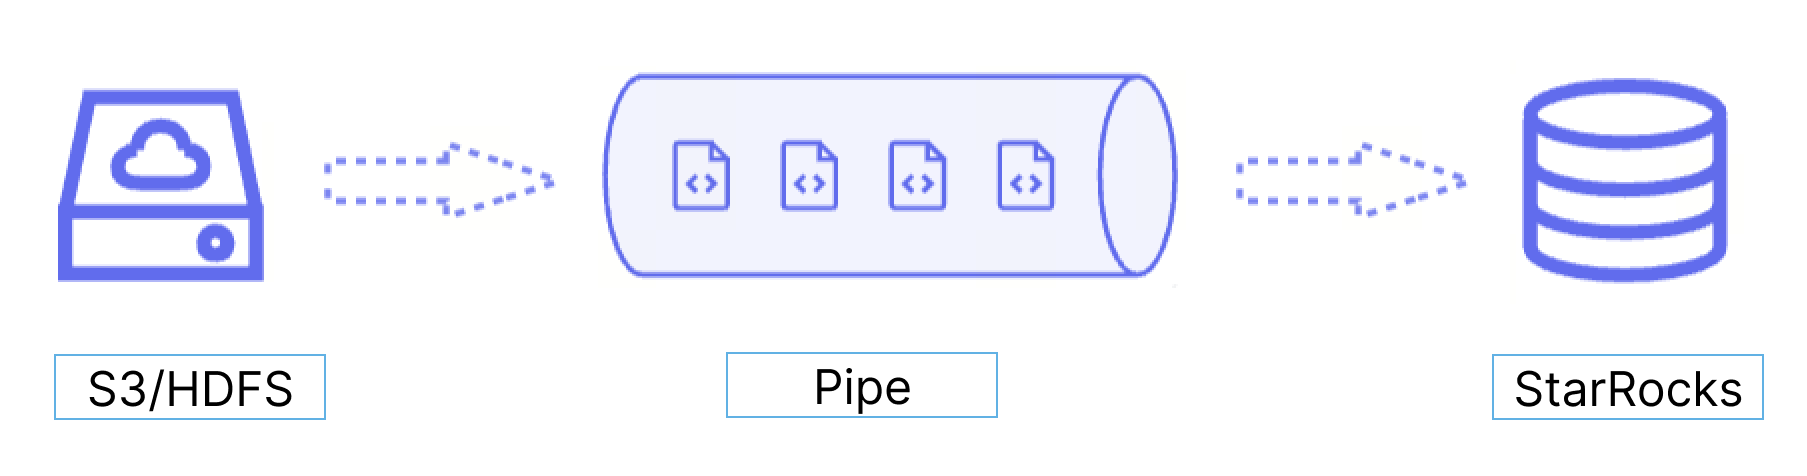
Pipe は、継続的なデータロードと大規模なデータロードに最適です:
-
大規模なデータロードをマイクロバッチで行うことで、データエラーによるリトライのコストを削減します。
Pipe を使用することで、StarRocks は大量のデータファイルを効率的にロードできます。Pipe はファイルの数やサイズに基づいて自動的にファイルを分割し、ロードジョブを小さな連続タスクに分解します。このアプローチにより、1 つのファイルのエラーが全体のロードジョブに影響を与えることはありません。Pipe は各ファイルのロードステータスを記録し、エラーを含むファイルを簡単に特定して修正できます。データエラーによるリトライの必要性を最小限に抑えることで、コストを削減します。
-
継続的なデータロードにより、人件費を削減します。
Pipe は、新しいまたは更新されたデータファイルを特定の場所に書き込み、これらのファイルから新しいデータを継続的に StarRocks にロードするのを支援します。
"AUTO_INGEST" = "TRUE"を指定して Pipe ジョブを作成すると、指定されたパスに保存されたデータファイルの変更を常に監視し、データファイルから新しいまたは更新されたデータを自動的に宛先の StarRocks テーブルにロードします。
さらに、Pipe はファイルの一意性チェックを行い、重複データのロードを防ぎます。ロードプロセス中、Pipe はファイル名とダイジェストに基づいて各データファイルの一意性をチェックします。特定のファイル名とダイジェストを持つファイルがすでに Pipe ジョブによって処理されている場合、その後の同じファイル名とダイジェストを持つファイルはすべてスキップされます。HDFS はファイルダイジェストとして LastModifiedTime を使用します。
各データファイルのロードステータスは information_schema.pipe_files ビューに記録され保存されます。ビューに関連付けられた Pipe ジョブが削除されると、そのジョブでロードされたファイルに関する記録も削除されます。
データフロー
Pipe と INSERT+FILES() の違い
Pipe ジョブは、各データファイルのサイズと行数に基づいて 1 つ以上のトランザクションに分割されます。ユーザーはロードプロセス中に中間結果をクエリできます。対照的に、INSERT+FILES() ジョブは単一のトランザクションとして処理され、ユーザーはロードプロセス中にデータを表示することはできません。
ファイルロードの順序
各 Pipe ジョブに対して、StarRocks はファイルキューを維持し、そこからデータファイルを取得してマイクロバッチとしてロードします。Pipe は、データファイルがアップロードされた順序でロードされることを保証しません。そのため、新しいデータが古いデータよりも先にロードされることがあります。
典型的な例
データベースとテーブルの作成
データベースを作成し、切り替えます:
CREATE DATABASE IF NOT EXISTS mydatabase;
USE mydatabase;
手動でテーブルを作成します(HDFS からロードしたい Parquet ファイルと同じスキーマを持つことをお勧めします):
CREATE TABLE user_behavior_replica
(
    UserID int(11),
    ItemID int(11),
    CategoryID int(11),
    BehaviorType varchar(65533),
    Timestamp varbinary
)
ENGINE = OLAP
DUPLICATE KEY(UserID)
DISTRIBUTED BY HASH(UserID);
Pipe ジョブの開始
次のコマンドを実行して、データファイル /user/amber/user_behavior_ten_million_rows.parquet から user_behavior_replica テーブルにデータをロードする Pipe ジョブを開始します:
CREATE PIPE user_behavior_replica
PROPERTIES
(
    "AUTO_INGEST" = "TRUE"
)
AS
INSERT INTO user_behavior_replica
SELECT * FROM FILES
(
    "path" = "hdfs://<hdfs_ip>:<hdfs_port>/user/amber/user_behavior_ten_million_rows.parquet",
    "format" = "parquet",
    "hadoop.security.authentication" = "simple",
    "username" = "<hdfs_username>",
    "password" = "<hdfs_password>"
);
このジョブには 4 つの主要なセクションがあります:
pipe_name: Pipe の名前。Pipe 名は、Pipe が属するデータベース内で一意である必要があります。INSERT_SQL: 指定されたソースデータファイルから宛先テーブルにデータをロードするために使用される INSERT INTO SELECT FROM FILES ステートメント。PROPERTIES: Pipe の実行方法を指定する一連のオプションパラメータ。これにはAUTO_INGEST、POLL_INTERVAL、BATCH_SIZE、BATCH_FILESが含まれます。これらのプロパティは"key" = "value"形式で指定します。
詳細な構文とパラメータの説明については、CREATE PIPE を参照してください。
ロード進捗の確認
-
SHOW PIPES を使用して Pipe ジョブの進捗をクエリします。
SHOW PIPES;複数のロードジョブを送信した場合は、ジョブに関連付けられた
NAMEでフィルタリングできます。例:SHOW PIPES WHERE NAME = 'user_behavior_replica' \G
*************************** 1. row ***************************
DATABASE_NAME: mydatabase
PIPE_ID: 10252
PIPE_NAME: user_behavior_replica
STATE: RUNNING
TABLE_NAME: mydatabase.user_behavior_replica
LOAD_STATUS: {"loadedFiles":1,"loadedBytes":132251298,"loadingFiles":0,"lastLoadedTime":"2023-11-17 16:13:22"}
LAST_ERROR: NULL
CREATED_TIME: 2023-11-17 16:13:15
1 row in set (0.00 sec) -
StarRocks Information Schema の
pipesビューから Pipe ジョブの進捗をクエリします。SELECT * FROM information_schema.pipes;複数のロードジョブを送信した場合は、ジョブに関連付けられた
PIPE_NAMEでフィルタリングできます。例:SELECT * FROM information_schema.pipes WHERE pipe_name = 'user_behavior_replica' \G
*************************** 1. row ***************************
DATABASE_NAME: mydatabase
PIPE_ID: 10252
PIPE_NAME: user_behavior_replica
STATE: RUNNING
TABLE_NAME: mydatabase.user_behavior_replica
LOAD_STATUS: {"loadedFiles":1,"loadedBytes":132251298,"loadingFiles":0,"lastLoadedTime":"2023-11-17 16:13:22"}
LAST_ERROR:
CREATED_TIME: 2023-11-17 16:13:15
1 row in set (0.00 sec)
ファイルステータスの確認
StarRocks Information Schema の pipe_files ビューからロードされたファイルのステータスをクエリできます。
SELECT * FROM information_schema.pipe_files;
複数のロードジョブを送信した場合は、ジョブに関連付けられた PIPE_NAME でフィルタリングできます。例:
SELECT * FROM information_schema.pipe_files WHERE pipe_name = 'user_behavior_replica' \G
*************************** 1. row ***************************
   DATABASE_NAME: mydatabase
         PIPE_ID: 10252
       PIPE_NAME: user_behavior_replica
       FILE_NAME: hdfs://172.26.195.67:9000/user/amber/user_behavior_ten_million_rows.parquet
    FILE_VERSION: 1700035418838
       FILE_SIZE: 132251298
   LAST_MODIFIED: 2023-11-15 08:03:38
      LOAD_STATE: FINISHED
     STAGED_TIME: 2023-11-17 16:13:16
 START_LOAD_TIME: 2023-11-17 16:13:17
FINISH_LOAD_TIME: 2023-11-17 16:13:22
       ERROR_MSG:
1 row in set (0.02 sec)
Pipe の管理
作成した Pipe を変更、停止または再開、削除、クエリし、特定のデータファイルのロードを再試行できます。詳細については、ALTER PIPE、SUSPEND or RESUME PIPE、DROP PIPE、SHOW PIPES、および RETRY FILE を参照してください。
